
Obejrzyj nagranie z webinaru:
Zaawansowana analityka z BigQuery – jak zarządzać danymi i wykorzystać je do rozwoju biznesu?
Czego się dowiesz?
Obejrzyj nagranie webinaru poświęconego budowaniu pełnego środowiska hurtowni danych w chmurze Google Cloud. Eksperci z FOTC: Tomasz Karsznia , Kamil Habrych oraz Mariusz Zyśk – krok po kroku prezentują proces analityczny: od pozyskania surowych danych, przez ich transformację i analizę z użyciem sztucznej inteligencji, aż po wizualizację. Z nagrania dowiesz się, jak wykorzystać potencjał Google BigQuery, aby uniezależnić się od limitów raportowych i maksymalnie wykorzystać wartość informacji w firmie.
TRANSKRYPCJA WEBINARU
Zaawansowana analityka z BigQuery – jak inteligentnie zarządzać danymi?
Prelegenci: Tomasz Karsznia, Kamil Habrych, Mariusz Zyśk
Data: 22.02.2024
Przedstawienie prowadzących
Tomasz Karsznia: Może zaczniemy od przedstawienia się. Ja jestem Tomek, pracuję w FOTC, jestem data inżynierem, zajmuję się analityką danych i data engineeringiem.
Kamil Habrych: Cześć, ja jestem Kamil. Razem z Tomkiem pracujemy w dziale data w FOTC. Zajmuję się głównie przetwarzaniem danych i analityką w BigQuery. Ponadto zajmuję się innymi tematami data w GCP dla naszych klientów w FOTC.
Mariusz Zyśk: Cześć, miło was tutaj wszystkich spotkać, jest nas bardzo dużo, z czego się bardzo cieszę. Ja jestem Mariusz Zyśk, pracuję w Laurens Coster 11 lat, z czego 6 ostatnich lat na pozycji CTO. Całe swoje życie zawodowe zajmowałem się danymi, hurtowniami danych. Naprawdę na koncie mam – razem z Laurens Coster oczywiście – fajne projekty danowe, a ostatnie kilka lat spędzamy nad wdrażaniem sztucznej inteligencji. Także tyle, dzięki na razie.
Agenda webinaru
- GA4 jako źródło danych
- BigQuery
- Integracja danych
- Machine Learning w BigQuery
- Generative AI
- Looker Studio
- Q&A
Dzisiaj chcielibyśmy wam opowiedzieć o tym w jaki sposób zbudować kompletne i pełne środowisko hurtowni danych, oczywiście uproszczone, bo mamy na to godzinkę. Ale uwierzcie nam, że w godzinę nam się uda to zrobić, czyli kompleksowy system hurtowni danych od źródła aż po analitykę danych.
Opowiem wam o źródle, które sobie wybraliśmy dla naszego demo i to będzie Google Analytics 4. Później opowiemy o samym BigQuery i jak zintegrować te dane. Pokażemy jak dokładnie to zrobić, żeby dzisiaj te dane się znalazły w BigQuery.
Następnie będzie moja część, o której będę miał przyjemność opowiadać, czyli AI-owa, machine learningowa moc BigQuery, z której powinniśmy korzystać. Następnie przejdziemy do Looker Studio i odpowiemy wam na wszystkie nurtujące was pytania.
Za co lubimy BigQuery?
Zanim zaczniemy, dawajcie znać proszę na czacie, za co wy najbardziej lubicie BigQuery. To pytanie też kieruję do moich współrozmówców tutaj, do Kamila i Tomka.
Ja odpowiadam pierwszy, ale trochę już się zdradziłem, że dla mnie najlepsze w BigQuery są te możliwości AI, które wam dzisiaj zresztą pokażę.
Tomasz Karsznia: Chyba jestem kolejny. Jak dla mnie najlepsze, to co najbardziej lubię, to możliwość zawarcia całej tabeli w jednej komórce, którą możemy w bardzo prosty sposób odczytać.
Kamil Habrych: Jeżeli chodzi o mnie, to ja najbardziej lubię to, że możemy agregować dane z wielu źródeł i przechowywać je w jednym miejscu.
Mariusz Zyśk: Ekstra, to są fajne rzeczy, o wszystkim dzisiaj też wam opowiemy. Ktoś widzę, że pisze wiadomość, za co lubi BigQuery, przeczytamy ją później. Teraz zacznijmy od opisu źródła.
Opis źródła danych – Google Analytics 4
Tomasz Karsznia: Tematem naszego webinaru jest analityka danych w BigQuery, lecz żeby cokolwiek wam dzisiaj pokazać, potrzebujemy sensownego przykładu. Prawdopodobnie większość z was ma GA4 i z niego korzysta, więc to powinien być idealny przykład.
Google Analytics 4 to narzędzie analityki webowej, tak słowem wprowadzenia, które pomaga właścicielom stron internetowych i marketerom w zrozumieniu i optymalizacji zachowań użytkowników na ich witrynach. Analytics dostarcza szeroki zakres informacji na temat ruchu na stronie, konwersji, interakcji użytkowników i innych ważnych wskaźników, które mogą być przydatne przy podejmowaniu decyzji biznesowych.
Dzięki Google Analytics właściciele stron i reklamodawcy mogą dokładnie śledzić, jak użytkownicy korzystają z ich witryn, jakie działania podejmują, jakie konwersje generują i tak dalej. Analytics zapewnia raportowanie w czasie rzeczywistym, co pozwala na szybsze podejmowanie decyzji biznesowych na podstawie aktualnych danych. Podsumowując, to narzędzie, które pozwoli nam śledzić ruch użytkowników na naszych stronach. A jak to skonfigurować? Już wam pokazuję.
Konfigurację Google Analytics 4 pokazujemy na nagraniu z webinariu (czas 4:13)
Po zalogowaniu do panelu Analyticsa naszej strony widzimy, że możemy już łączyć, ilu mamy nowych użytkowników, ilość sesji, ilość wydarzeń oraz wiele innych agregacji na podstawie naszych danych.
Mariusz Zyśk: Powiedz mi, skoro mamy tutaj w GA4 same takie możliwości, to po co te dane wrzucać do BigQuery?
Tomasz Karsznia: Dobre pytanie. Po pierwsze, istnieją ograniczenia w raportowaniu w Analytics. Przenosząc dane do BigQuery, mamy możliwość dostosowania danych do indywidualnego biznesu, czyli na przykład zbudowanie modelu ML – o tym powie Mariusz – czy zasilenie danymi innego narzędzia, jak marketing automation, bądź po prostu przygotowanie indywidualnych dashboardów per zespół.
Po drugie, dodatkowo dane w Analytics mają ważność tylko 14 miesięcy. Jeśli chcemy analizować historię, to BigQuery jest miejscem, z którego dane nie uciekną.
Przechodząc do panelu administracji, dostajemy możliwość połączenia z różnymi innymi usługami, takimi jak Google Ads czy w przypadku, gdy mamy sklep internetowy, to również Merchant Center, Google Play i kilkoma innymi. Ale nas w tym momencie interesuje tylko BigQuery.
Żeby go skonfigurować, przechodzimy do zakładki BigQuery links, klikamy „połącz” bądź „link” i uzupełniamy dane, takie jak projekt, dataset oraz częstotliwość eksportowania takowych danych. Tutaj też dodam od siebie, że taki streaming jest darmowy, więc zalecałbym raczej tę opcję, jeżeli nasza strona nie jest jakąś wielką maszyną. Teraz tak naprawdę po konfiguracji wystarczy poczekać do maksymalnie 24 godzin, aby dane spłynęły, gdzie potem i tak będą spływać już automatycznie same z siebie.
Czym jest BigQuery?
Przed następną częścią udostępnimy wam szybką ankietę, czy korzystaliście już z BigQuery.
Kamil Habrych: W międzyczasie opowiem trochę o BigQuery. BigQuery jest to usługa bezserwerowej, skalowalnej hurtowni danych w chmurze, która pozwala obsłużyć miliony zapytań oraz analitykę SQL bez konieczności zamartwiania się kosztownym utrzymywaniem zaawansowanej infrastruktury, skalowaniem bądź też rozłożeniem ruchu. Dlatego jedyne, czym musimy się zajmować w BigQuery, to tylko i wyłącznie dane i co z nimi chcemy zrobić.
Mariusz Zyśk: Super, ankieta jest w toku. Słuchajcie, super, że odpowiadacie: 137 odpowiedzi póki co, 139. 30% deklaruje, że korzysta, 32% deklaruje, że nie korzysta, a 25% z was nie korzysta, ale planuje zacząć, co nas bardzo cieszy i mam wrażenie, że dzisiaj was do tego przekonamy.
Widzę, że są też super pytania na czacie. Na wszystkie chętnie odpowiemy, ale myślę, że na Q&A, bo to będzie fajny czas na to. A teraz myślę, że możemy już przejść dalej, bo też mamy harmonogram napięty, chcemy wam dużo dzisiaj pokazać.
Główne zalety BigQuery
Kamil Habrych: Skoro wiemy już, co to jest BigQuery, teraz przejdźmy do głównych jego zalet. Głównymi zaletami są między innymi skalowalność, która umożliwia przechowywanie i analizowanie dużych ilości danych bez konieczności inwestowania w jakakolwiek infrastrukturę. Ponadto BigQuery może przetwarzać dane z prędkością aż do 100 terabajtów na godzinę oraz przechowywać do 100 petabajtów danych.
Inną zaletą BigQuery jest prosta i intuicyjna obsługa. BigQuery możemy wykorzystywać na wiele różnych sposobów: czy to poprzez przeglądarkę internetową w konsoli Google Cloud z poziomu BigQuery Studio, czy to przez API, bądź też przez wiersz poleceń. Później pokażę wam demo, jak wygląda BigQuery Studio i zobaczycie, że BigQuery oferuje przejrzysty i przyjazny interfejs użytkownika. Ponadto BigQuery jest obsługiwany przez język SQL, więc jeżeli ktoś ma podstawy z SQL, to w pełni może sobie poradzić z obsługą BigQuery.
Trzecią zaletą są integracje, ponieważ możemy integrować się z ogromnej liczby źródeł. Integracje możemy podzielić na dwa typy:
- takie, które wymagają jedynie kilku kliknięć – tak jak pokazywał Tomek w przypadku GA4, gdzie za pomocą dosłownie paru kliknięć możemy te dane eksportować do BigQuery (podobnym przykładem takich integracji są YouTube Ads czy Google Ads).
- Istnieją jeszcze integracje, które wymagają nieco więcej konfiguracji bądź czasu, gdyż nie mają natywnych konektorów, lecz można je samemu stworzyć lub wykorzystać do tego inne usługi.
Mariusz Zyśk: Jeśli mogę Ci wejść w słowo, Kamilu, to trzeba zaznaczyć, że w hurtowni danych można po prostu zintegrować dowolne źródło sposobami inżynierskimi. My w Laurens Coster mamy takie powiedzonko, że nie potrafimy danych integrować tylko z ludzkich heads póki co. Także naprawdę jest nieskończoność możliwości programistycznych, żeby te dane pakować tam z dowolnego źródła.
Kamil Habrych: Kolejną główną zaletą jest między innymi bezpieczeństwo, ponieważ BigQuery używa OAuth 2.0 do uwierzytelnienia użytkowników i IAM do autoryzacji dostępów do zasobów. Ponadto można na dataset w BigQuery nadawać różne rodzaje dostępów dla użytkowników. Możemy zrobić dostępy tylko na konkretne wiersze bądź też na konkretne kolumny. Czyli mając jeden ogromny zbiór danych, gdy potrzebujemy nadać danej części użytkowników tylko określony dostęp, możemy to śmiało zrobić bez najmniejszych problemów.
Przypadki użycia (Use Cases)
Przechodząc dalej do głównych use case’ów, które możemy wykorzystać: na dzisiejszym webinarze poruszymy pierwszy use case, czyli transfer danych (w naszym przypadku będzie to GA4). W następnym slajdzie pokażę wam, jakie są jeszcze inne możliwości transferu danych, z czego możemy skorzystać i co oferuje BigQuery w tym przypadku.
Innymi use case’ami jest migracja hurtowni danych. Ponadto BigQuery jest na tyle uniwersalne, że możemy korzystać z niego jako narzędzia pośredniego bądź bezpośredniego. Co rozumiem przez narzędzie pośrednie? Jest to miejsce, w którym zbieramy dane z różnych źródeł – czyli use case pierwszy: transferujemy dane z GA4, przechowujemy je w BigQuery i możemy robić na tych danych różne transformacje. A jako miejsce docelowe możemy wykorzystać model machine learningowy bądź wizualizacje czy dashboardy w Lookerze.
Natomiast możemy również traktować BigQuery jako narzędzie docelowe, czyli tak jak w przypadku migracji hurtowni danych, kiedy potrzebujemy przenieść nasze dane z innej chmury publicznej bądź z on-premisa.
Kolejnym use case’em jest analiza w czasie rzeczywistym. Możemy tworzyć SELECT-y bądź cykliczne zapytania (co później pokażę), dzięki czemu w naszych dashboardach możemy odświeżać dane niemalże w czasie rzeczywistym. Przez to, że BigQuery jest bardzo skalowalne, umożliwia wykonywanie zapytań na ogromnej ilości danych.
Kolejnymi use case’ami są między innymi hurtownia danych dla marketingu, ponieważ możemy wykorzystywać BigQuery jako miejsce docelowe, gdzie zaciągamy dane z różnych źródeł. Tak jak w przypadku GA4, możemy zaciągać dane z Facebooka, z Linkedina, z Instagrama bądź też innych aplikacji, dzięki czemu możemy wykorzystać te dane później do tworzenia modeli machine learningowych bądź wizualizacji. BigQuery jest świetną furtką do wykorzystania potencjału sztucznej inteligencji, co później pokaże Mariusz.
Możliwości transferu i archiwizacji danych
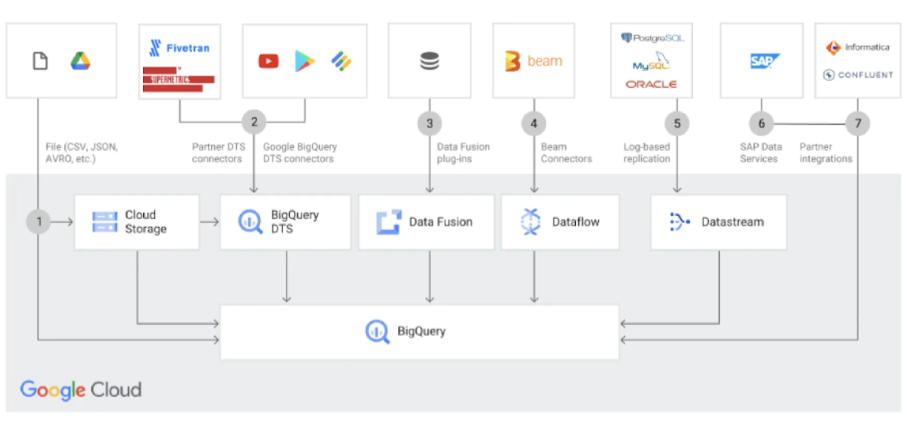
Przedstawiam wam diagram możliwości transferu danych do BigQuery, o którym wcześniej wspomniałem. Jak widzicie, mamy tu szeroki wachlarz możliwości, począwszy od wrzucania zwykłych plików CSV czy JSON bezpośrednio do BigQuery, bądź też pośrednio przez Cloud Storage. Ale możemy na przykład wykorzystać też Dataflow, Datastream czy urządzenie o nazwie BigQuery Data Transfer Service, o którym zaraz więcej opowiem. Mamy ogromny wachlarz opcji – to zależy od was, z czego skorzystacie. BigQuery nie zamyka się tylko na jedno źródło, skąd możemy pobierać te dane.
BigQuery Data Transfer Service to darmowa usługa zawarta w BigQuery, która umożliwia w bardzo łatwy sposób przesyłanie danych z wielu źródeł, między innymi z YouTube, Google Ads bądź też innych źródeł Google lub spoza Google, do przechowywania i analizowania tych danych, aby odkrywać trendy, podejmować decyzje biznesowe i uzyskiwać wgląd w zgromadzone dane.
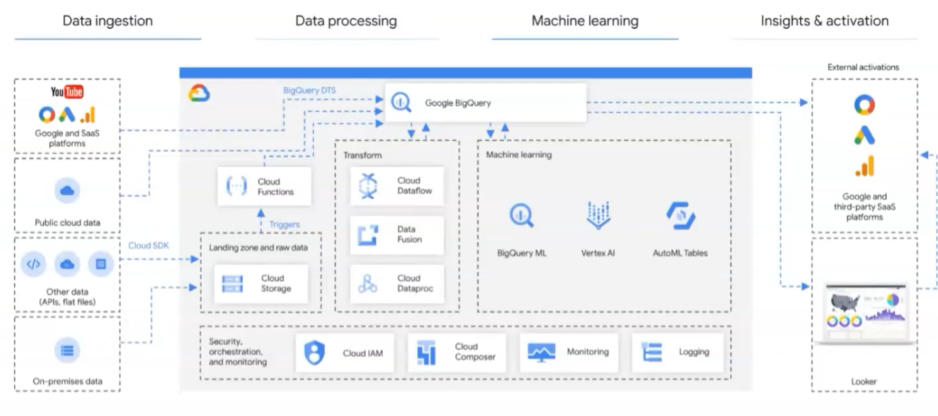
Co do hurtowni danych dla marketingu: na diagramie możecie zobaczyć bardzo złożony proces. Spoglądając na niego od lewej do prawej, widzimy na przykład źródło, którym może być YouTube, i chcemy te dane z YouTube zaciągać do BigQuery, czyli wykorzystujemy BigQuery Data Transfer Service. W samym BigQuery możemy albo te dane wykorzystać bezpośrednio już do machine learningu, korzystając z takich usług jak BigQuery ML czy Vertex AI, natomiast jeżeli te surowe dane nam nie odpowiadają, to możemy w jakiś sposób je transformować za pomocą Dataforma, o którym zaraz opowiem więcej. Docelowo możemy te dane – transformowane bądź surowe – przedstawić w dashboardzie w Lookerze.
Prezentacja BigQuery Studio
Część demonstracyjna z konsoli Google Cloud dostępna na nagraniu z webinaru (czas: 16:30)
Przejdźmy teraz do konsoli Google Cloud. Z panelu głównego Google Cloud wybieramy BigQuery i tak nam się prezentuje BigQuery Studio w naszej przeglądarce.
Rozwinąłem nasze zbiory danych, jakie mam obecnie. O Dataform opowiem zaraz, teraz chciałbym się skupić na dataset, który zaciąga dane z GA4. Jak widzicie, mamy tutaj tabelę events i liczbę 92. Dane z GA4 zaciągane są do BigQuery w taki sposób, że wykorzystywane są do tego tabele partycjonowane, czyli podział dużej tabeli na mniejsze, co umożliwia łatwiejsze zarządzanie segmentami. W tym przypadku eventy są podzielone na tabele partycjonowane – jedna tabela partycjonowana to są dane z GA4 z danego dnia. Dzięki temu praca na zapytaniach jest o wiele szybsze, ponieważ skanują się tylko te partycje, które potrzebujemy do zwrócenia wyniku, i nie musimy podnosić całej ogromnej tabeli.
Przechodząc do schemy tych danych z GA4, widzimy, kiedy ten event wleciał do BigQuery, kiedy został wygenerowany przez GA4. Głównie mamy tu informacje o parametrach, o user ID, ponadto mamy informacje o ruchu, geolokalizacji bądź też urządzeniu, z którego korzystał użytkownik.
Ciekawa rzecz: nie musimy odpytywać tabeli, jeżeli nie wiemy, co w niej jest, żeby zobaczyć jej treść i niepotrzebnie ponosić kosztów zapytania. Możemy w łatwy sposób wykorzystać zakładkę „preview”, która umożliwia nam obejrzenie pierwszych 50 wierszy z danej tabeli. Jest to kompletnie za darmo. Jak widzimy tutaj, mamy event pierwszej wizyty jakiegoś użytkownika i mamy informację na przykład, że korzystał on z iPhona. W łatwy sposób możemy zobaczyć najważniejsze dane i ogólnie zobaczyć, z czego składa się dana tabela.
Aby wywołać zapytanie w BigQuery, klikamy przycisk Query i otwieramy to w nowej zakładce. Jeżeli ktoś umie SQL bądź zna jego podstawy, to w łatwy sposób możemy stworzyć te zapytania. Tutaj odpytujemy naszą tabelę z 31 stycznia.
Mamy też opcję wykorzystania „scheduled queries”, czyli cyklicznych zapytań, które wywołują się na przykład w określonych godzinach bądź codziennie o konkretnej godzinie. To znaczy, jeżeli chcemy, żeby to zapytanie wywoływało się cyklicznie, wystarczy, że klikniemy przycisk schedule i za pomocą kilku parametrów ustawiamy, że to konkretne zapytanie może się wywoływać co 24 godziny. Za pomocą przycisku save zapiszemy to i kolejnego dnia o 10:23 to zapytanie zostanie wywołane. Wszystkie zapytania, które sobie zapiszemy jako scheduled queries, możemy zobaczyć w zakładce o tej samej nazwie. Tam nam się wszystko wyświetli, możemy nimi zarządzać, usuwać, także jest to bardzo fajna opcja, żeby móc podejrzeć nasze skonfigurowane cykliczne zapytania.
W data transfers mamy to, o czym wcześniej mówiłem, czyli BigQuery Data Transfer Service, gdzie możemy stworzyć w łatwy sposób transfer danych. Wybieramy źródło, załóżmy Google Ads, i wpisujemy dosłownie kilka parametrów: jak będzie się nazywała ta konfiguracja, jak często ma być wywoływana, gdzie te dane mają wpadać w BigQuery oraz nasz Customer ID w Google Ads. Uzupełniając tylko te kilka opcji, klikamy save i w określonych godzinach ustawionych przez nas mamy ten transfer zrobiony. Dla przykładu mam tu stworzony data transfer, który opiera się na kopiowaniu datasetów. Widzimy w łatwy sposób, jakie transfery zostały przeprowadzone pomyślnie, mamy godzinę wykonania oraz podsumowanie. Natomiast jeżeli coś wydarzy się w trakcie tego transferu, na przykład zostanie usunięte źródło, to od razu dostaniemy informację, że coś jest nie tak i musimy to naprawić.
Przechodząc dalej po opcjach, mamy coś takiego jak Analytics Hub. Jest to miejsce do współdzielenia danych między organizacjami. Posiadając dane w jednej organizacji – załóżmy, że dla danego klienta pracują dwie firmy, na przykład FOTC i Laurens Coster pracują nad jednym projektem, FOTC wykonało swoją część pracy, ale te same dane potrzebuje Laurens Coster na przykład do wykorzystania ML-a – możemy stworzyć „exchange” i te dane współdzielić między organizacjami.
Co ważne, jako ciekawostka: jeżeli zapytania zostaną wykonane przez firmę A, to jest to płacone przez firmę A, natomiast jeżeli druga firma wykona inne zapytania, to będzie obarczony ich rachunek. Mamy tu rozgraniczenie tych kosztów pomiędzy organizacjami.
Mariusz Zyśk: Warto dodać, że za storage płaci jedna firma, która hostuje projekt.
Transformacja danych z Dataform
Kamil Habrych: Przechodząc do przedostatniej opcji, którą chciałbym dzisiaj pokazać, jest to Dataform. Wcześniej stworzyłem jedno przykładowe repozytorium i workspace. Dataform służy do transformacji danych, które znajdują się w BigQuery. Załóżmy, wpadają nam surowe dane z GA4, ale nie odpowiadają nam i potrzebujemy je w pewien sposób zmodyfikować, żeby były gotowe na przykład do modelu machine learningowego czy do wizualizacji. Dataform to idealne narzędzie do tego, ponieważ za pomocą plików SQLX możemy tworzyć operacje typu: coś usunąć, coś zmodyfikować. W łatwy sposób możemy zobaczyć, jak to jest poprowadzone.
Stworzyłem wcześniej bardzo prosty przykład z wykorzystaniem dwóch widoków. Pierwszy to SELECT napisu „webinar”, natomiast drugi widok odwołuje się referencyjnie do pierwszego widoku i wyświetla to, co jest w pierwszym. Co ważne, możemy od razu zobaczyć, czy query jest prawidłowe, mamy naszego SELECT-a, jak wyglądałoby query, możemy to sprawdzić. Ponadto możemy zobaczyć, jak wygląda to na grafach, czyli widzimy, że second view musi się wykonać po wykonaniu first view. Takie zależności bardzo przydadzą nam się w bardziej skomplikowanej pracy.
Mariusz Zyśk: W dużych i w każdym projekcie hurtownianym pracujemy z Dataformem. Można tam w bardzo fajny i przyjemny sposób zaimplementować procesy CI/CD, pracować z kodem SQL, wersjonowaniem i pozwala to na to, żeby postawić w innym projekcie dwoma kliknięciami całość naszego modelu. Ewa już podrzuciła wam linka na czacie do prelekcji z Data Science Summit, jeśli chcielibyście posłuchać, tam o tym mówiłem.
Generowanie zapytań z Duet AI
Kamil Habrych: Przejdźmy do ostatniej rzeczy, którą chciałem wam przedstawić. Jest to dosyć nowa funkcja w BigQuery, a mianowicie nazywa się Duet AI. Z poziomu BigQuery oraz Google Cloud możemy wykorzystywać prompty do generowania różnych zapytań.
Załóżmy, jestem osobą stricte biznesową, nietechniczną i nie znam podstaw SQL, a potrzebuję coś wyciągnąć z naszych danych, przykładowo z GA4. Wystarczy, że napiszemy w prompcie, że potrzebuję sprawdzić, ile eventów oraz jakiego typu wleciało do BigQuery oraz zostało wygenerowanych w GA4 załóżmy 31 stycznia tego roku w naszym datasiecie ga4_webinar. Pozwolę sobie skopiować ten prompt, o którym właśnie powiedziałem, i w łatwy sposób Duet AI wygeneruje nam to zapytanie. Możemy je skopiować i zweryfikować.
Widzimy, że nasze query jest prawidłowe. Uruchommy je sobie i widzimy, jaki event i ile tych eventów konkretnego typu było 31 stycznia. Za pomocą zwykłych zapytań – czasami wystarczy tylko dorzucić jakiś szczegół, czyli jaki to ma być dataset, o jakiej nazwie, z jakiego dnia – w łatwy sposób możemy sprawdzić dane, które znajdują się w BigQuery, a na przykład nie mamy pojęcia, jak napisać to zapytanie.
Mariusz Zyśk: To jest fajny wstęp do demokratyzacji danych, do tego, żeby dane przestały być dostępne tylko pod ręką użytkowników technicznych, znających języki kodowania, takie jak SQL. Tutaj możemy przejść do tego co oferuje nam AI w samym BigQuery.
Sztuczna inteligencja i Machine Learning w BigQuery
BigQuery zmienia sposób, w jaki postrzegamy dane i daje nam gigantyczne możliwości. Musimy zrozumieć jedną ważną rzecz: sztuczna inteligencja i machine learning zaczynają się od danych. Bez danych, które są fundamentem, nie jesteśmy w stanie nic mądrego przygotować. A czasami, jeśli mamy dane słabej jakości, to na zasadzie GIGO (Garbage In, Garbage Out) – jeśli zasilimy model bardzo niefajnymi, niezdrowymi danymi, to tak samo możemy otrzymać wyniki, które mogą nam nieco przeszkadzać. Od danych się zaczyna i nie chodzi tylko o posiadanie danych, bo ważne także jest, jak są zorganizowane, czyli w jaki sposób je odświeżamy, w jaki sposób je układamy (po to jest między innymi Dataform). Musimy pamiętać, że to jest ostatni dzwonek, żeby posprzątać swoje dane, bo inaczej ten pociąg AI może wam uciec. Gdybyście nie wiedzieli, jak zdążyć na ten pociąg, to my wam chętnie pomożemy.
Możliwości BigQuery są bardzo duże. Korzystając z dobrodziejstw modeli językowych Google z poziomu kodu SQL, możemy wygenerować teksty, opisy obrazów i tak dalej:
- NLP (Natural Language Processing) pozwala nam zrozumieć, syntetyzować i analizować sentyment niektórych wypowiedzi.
- Machine Translation – każdy z nas zna to z Google Translate.
- Text Embeddings – funkcja zamieniająca string (słowo) na listę liczb zmiennoprzecinkowych, co jest potrzebne na przykład do semantic search.
- Audio Transcription – bezpośrednio w BigQuery możemy przeprowadzić transkrypcję naszych nagrań.
- Document Processing – możemy procesować dokumenty PDF, zrobić invoice parsera.
- Computer Vision – analiza obrazków.
- Customowe modele ML – budowanie własnych modeli, na przykład do churn prediction.
Demo: Funkcje AI i modele ML w praktyce
Demo dostępne na nagraniu z webinaru (czas 30:30)
Zacznijmy od mojego krótkiego demo. Chciałem wam pokazać, jak banalnie proste i wspaniałe są te funkcjonalności ML-owe w BigQuery.
Żeby odpalić dowolną z tych funkcji, trzeba najpierw stworzyć model. Krótkim poleceniem tworzę model do LLM-a – akurat zapiąłem Bisona, można też zapiąć oczywiście Gemini. Używam funkcji ML.GENERATE_TEXT, podaję model, który stworzyłem, i parę parametrów. Zadałem pytanie naszemu modelowi: „Dlaczego warto wrzucić dane z GA4 do BigQuery?”.
Model odpisuje nam bezpośrednio w bazie danych. Dostajemy informację, że jest wiele powodów, m.in. dostęp do danych na poziomie zdarzeń, możliwość łączenia danych z innych źródeł, skalowalność, łatwość skorzystania, niski koszt.
Kolejny przykład to analiza sentymentu. Miałem przykład opinii ze swojej ulubionej kebabowni w Google, to była opinia, którą skopiowałem i postanowiłem sprawdzić, jak ją Natural Language Processing z funkcją analizy sentymentu: „Niska cena, niskie oczekiwania, byłem trzy razy, jeśli nie będę miał innej możliwości, będę czwarty raz”. Sprawdziłem, jak oceni ją funkcja. Okazuje się, że sentyment jest dość wysoki, więc to jest dobra opinia, co potwierdza model. Dodatkowo są tam cztery gwiazdki w opinii, więc analiza sentymentu działa dobrze
Kolejna funkcja pozwala na tłumaczenie (Machine Translation) – tę samą opinię przetłumaczyłem na język angielski: „Low price, low expectations. I’ve been there 3 times. If i have no other option, i will be there for the fourth time”
Embeddings zamienia opinię na ciąg liczb zmiennoprzecinkowych.
Zaczynają się też bardziej zaawansowane rzeczy, do których wykorzystujemy Google Cloud Storage i buckety, w których umieszczamy pliki. Tak samo trzeba było stworzyć w trzech linijkach model. Natomiast tutaj po przerzuceniu pliku do Cloud Storage, co jest banalnie proste i działa na zasadzie drag and drop, ja wrzuciłem swój plik i stworzyłem coś takiego jak External Table, gdzie wskazałem plik nagrania audio. Używam funkcji ML.TRANSCRIBE, podaję model, tabelę, konfigurację (język polski) i baza przepisała moje nagranie: „Cześć, mam nadzieję, że ten Webinar Ci się podoba”.
Document Processing działa na podobnym schemacie: mamy bucket, External Table z fakturą i używamy ML.PROCESS_DOCUMENT. W BigQuery zamieniamy fakturę w JSON-a ze wszystkimi informacjami o adresach, NIP-ach, pozycjach i VAT.
W przypadku Computer Vision tworzymy tabelę na podstawie obrazków i używamy ML.ANNOTATE_IMAGE. Model rozpoznał na obrazku samochód na 96%, koło, oponę, grill, automotive oraz budynek w tle. To rzeczywiście jest obrazek, który tam podrzuciłem.
Można też łączyć te funkcje: przeanalizować sentyment rozmów telefonicznych, wrzucając nagrania audio do bucketa, robiąc ML.TRANSCRIBE, a potem analizę sentymentu.
Budowa modelu predykcji odejść (Churn Prediction)
Przejdźmy do modelu predykcyjnego. Pierwszym krokiem jest Feature Engineering, czyli przygotowanie inputu treningowego do modelu.
Warto zaznaczyć, jak można odpytywać tabele partycjonowane – można użyć na przykład TABLESAMPLE SYSTEM (1 PERCENT) do pobrania próbek.
Tworzę widok reprezentujący moją logikę biznesową, gdzie zdefiniowałem churn i bounce. Dla mnie churn to osoba, która nie zrobiła żadnej akcji później niż 24 godziny po pierwszej akcji, a bounce to osoba, która wykonała ostatnią akcję maksymalnie do 10 minut od pierwszej.
Następnie tworzę widok z cechami demograficznymi (skąd jest użytkownik, jaki system operacyjny, język) oraz behawioralnymi (ile razy dokonał jakiejś akcji, ile razy otworzył stronę, przescrollował, zobaczył produkty).
W kolejnym etapie łączymy to w zbiór treningowy. Przeszliśmy przez 200 linii kodu feature engineeringu i dopiero teraz przechodzimy do ML.
Używamy polecenia CREATE MODEL i regresji logistycznej, wskazując churn jako label. Zbudowanie modelu trwało 51 sekund. Użyłem funkcji ML.PREDICT, aby sprawdzić, kogo przewidujemy, że zaraz odejdzie (ze szczególnym uwzględnieniem osób, które jeszcze nie odeszły, ale jest wysokie prawdopodobieństwo, że to zrobią – to grupa, o którą warto zadbać).
Wizualizacja danych w Looker Studio
Demo Looker Studio dostępne na nagraniu z webinaru (czas:45:55)
Tomasz Karsznia: Looker Studio to profesjonalna prezentacja danych, która umożliwia kreowanie interaktywnych zestawień. Użytkownicy mogą łatwo połączyć się z różnymi źródłami danych, tworzyć wizualizacje i udostępniać wyniki innym. Jest to darmowe rozwiązanie dostępne przez konto Google.
Możemy skorzystać z gotowych szablonów stworzonych przez Google (np. dla GA4) i bezpośrednio połączyć dane pomiędzy Analytics a Lookerem poprzez Add data -> wybór konta i usługi.
Naszym celem jest jednak zwizualizowanie danych z BigQuery oraz modelu wytrenowanego wcześniej. Dodanie źródła danych z BigQuery wymaga kilku kliknięć: Add Data -> BigQuery -> wybór projektu, datasetu i tabeli. Looker Studio posiada całą masę konektorów.
W Looker Studio mamy możliwość tworzenia interaktywnych elementów (combo boxy, checkbox, data range). Możemy wyfiltrować użytkowników na przykład z Anglii i po dwóch sekundach nasze dane opierają się tylko na tej grupie.
Zamiast dodawać całą tabelę, możemy dodać własne zapytanie SQL (Custom Query), które odpytuje model o wynik. Wklejamy zapytanie posiadające mniej kolumn, przez co jest lżejsze. Każdy użytkownik ma przypisany wskaźnik churn oraz predicted churn. Wyfiltrowując te dane, uzyskujemy grupę użytkowników, do których warto skierować akcje marketingowe (np. newsletter).
Pytania i odpowiedzi (Q&A)
Mariusz Zyśk: Udało nam się w niecałą godzinę przejść przez budowę całego ekosystemu do zarządzania danymi – od źródła po wizualizację i wykorzystanie AI. Dostępne jest repozytorium na GitHubie z materiałami pod kodem QR. Zapraszamy serdecznie na Google Cloud Days od 15 do 17 maja w warszawskim biurze Google. Przejdźmy teraz do sesji Q&A.
P: Czy Looker działa szybciej na samym imporcie z BigQuery?
Looker działa szybciej na imporcie z BigQuery. Looker potrafi bezpośrednio połączyć się z GA4 przez API, ale tam są ograniczenia. BigQuery to potężna machineria z wieloma zasobami, która bardzo szybko dostarcza informacje i nie trzeba się martwić limitami zapytań.
P: Jak prezentują się koszty BigQuery?
Pricing można rozpatrywać w dwóch kategoriach. Po pierwsze, płaci się za storage (jeśli dane są rzadziej używane, płaci się mniej). Głównym kosztem jest zazwyczaj ilość przetworzonych danych – około 6 dolarów za 1 TB przetworzonych danych. Wszystko zależy od workloadu, ale ogólnie uznaje się to za rozwiązanie dość tanie i potężne.
P: Czy można importować dane z backendu do BigQuery?
Tak, można to robić. Ogranicza nas tylko wyobraźnia, raczej nie ma technologii, której nie potrafilibyśmy dzisiaj zintegrować i wsadzić danych do BigQuery.
P: Jeśli dziś podłączę dane z GA4, to dane archiwalne sprzed 14 miesięcy się zaciągną?
Sprzed 14 miesięcy się nie zaciągną, zaciągną się tylko dane do 14 miesięcy wstecz. Jeśli chcemy dbać o historię, musimy włączyć eksport, żeby zacząć ją gromadzić.
P: Czy Duet AI jest dodatkowo płatny?
Kamil Habrych: Obecnie Duet AI do 11 maja tego roku jest darmowy dla jednego użytkownika na jeden billing. Później będzie to kosztować 19 dolarów za użytkownika miesięcznie przy planie rocznym.
P: Jak optymalizować tabele w BigQuery, aby dashboardy nie tworzyły kosztownych jobów z Lookera?
Tomasz Karsznia: Tworząc data source, Looker sam co 12 godzin podnosi tabelę. Dobrą praktyką jest okrojenie ilości kolumn w zapytaniu tylko do tych, których rzeczywiście używamy. Jeśli eksport z GA4 działa co 24 godziny, nie ma potrzeby odświeżać danych w Lookerze częściej. Looker sam w sobie cashuje zestaw danych, który odpytuje co 12 godzin.
P: Jaka jest różnica między Dataform a tworzeniem widoków i tabel przy pomocy Scheduled Queries?
Mariusz Zyśk: W Dataformie możemy za pomocą jednego kliknięcia stawiać całe modele hurtowni danych w innych projektach.
P: Czy Duet AI jest podpięte pod Gemini?
Kamil Habrych: Z tego co się orientuję to Duet AI jest teraz podpięty pod Gemini.
P: Czy Dataform jest dodatkowo płatny, czy wystarczy podpiąć kartę?
Kamil Habrych: Dataform sam w sobie jest usługą darmową. Wszystkie operacje w nim (np. SELECT-y) są rozliczane na takich samych zasadach jak zwykłe zapytania w BigQuery.
P: Jakie są koszty wykorzystywania modeli AI? Czy za każde odpytanie modelu nalicza koszty?
Mariusz Zyśk: Każdy z modeli jest rozliczany osobno według swojego cennika. Na przykład Speech-to-Text (transkrypcja audio) rozliczany jest za sekundy nagrania, a Vision za liczbę przetworzonych obrazów. (Sprostowanie odnośnie eksportu z GA4: darmowy w podstawowej wersji GA4 jest eksport dzienny (Daily) wysyłany co 24 godziny, a nie streaming).
P: Czy BigQuery może być przydatne do obrabiania danych finansowych, analizowania i wrzucania plików CSV?
To perfekcyjne zastosowanie. Wrzucenie CSV przez BigQuery Data Transfer Service i analityka w Lookerze to super przykład. Można też podpiąć modele predykcyjne do prognozowania.
P: Jak wygląda kwestia poufności danych? Czy treści nagrań wrzucane do AI są wykorzystywane do trenowania modelu?
Nie. Google gwarantuje, że dane przesyłane w ten sposób nie są wykorzystywane do trenowania modeli publicznych. Wszystkie dane wysyłane do AI są dodatkowo szyfrowane.
P: W jaki sposób możemy oczyścić dane tekstowe z danych poufnych (PII) przed wrzuceniem treści do modelu AI?
Można ograniczyć widok bądź dostęp do danej kolumny, wyczyścić dane z poziomu zapytań SQL lub użyć dedykowanej usługi Google Cloud Data Loss Prevention (DLP), która automatycznie maskuje dane poufne. Można też użyć promptów AI do wycięcia PII.
Jesteśmy trochę po czasie, mam nadzieję, że Wam się podobało. Widzę też pozytywne komentarze. Dzięki, wszystkiego dobrego!