
Obejrzyj nagranie z webinaru:
Jak bez rewolucji okiełznać rozproszone dane w e-commerce
Czego dowiesz się podczas webinaru?
Ekspert Fly on the Cloud, Mariusz Zyśk, wyjaśnia, jak zlikwidować silosy informacyjne pomiędzy marketingiem, sprzedażą a księgowością oraz jak wyeliminować opóźnienia w raportowaniu (lag decyzyjny). Dowiesz się, jak bezpiecznie zbudować hurtownię danych w modelu MVP oraz jak połączyć moc Google BigQuery, Looker Studio i sztucznej inteligencji (Vertex AI / Gemini) do automatyzacji analityki i predykcji zachowań klientów.
TRANSKRYPCJA WEBINARU
Jak bez rewolucji okiełznać rozproszone dane w e-commerce
Prelegent: Mariusz Zyśk
Data: 02.04.2026
Mariusz Wilczek: Już oficjalnie witam wszystkich serdecznie na webinarze pt. „Jak bez rewolucji okiełznać rozproszone dane w e-commerce”. Ze mną jest Mariusz Zyśk, nasz Data and AI Evangelist. Ja jestem Mariusz Wilczek i powoli już przejdziemy do meritum.
Zaczniemy od przedstawienia naszej firmy – Fly On the Cloud. Zajmujemy się wdrażaniem rozwiązań chmurowych, tworzymy inteligentne miejsca pracy, zajmujemy się też dbaniem w naszych firmach o dane i wdrażaniem AI. Nasza firma jest Google Cloud Premier Partner, przez co swoje rozwiązania bardzo często opieramy właśnie na rozwiązaniach od Google. Na rynku jesteśmy już ponad dekadę i współpracujemy z firmami z ponad 50 krajów. Mariuszu, ja tobie przekazuję już dalej tematykę webinaru.
Mariusz Zyśk: To jest dzisiejsza agenda. Nie będę czytał tych slajdów, bo ja wolę mówić niż do was czytać. Pogadamy sobie najpierw, dlaczego to jest takie trudne, że dane w e-commerce są rozproszone i co nas ogranicza tak naprawdę w tym, żeby wydobyć potencjał z naszych danych. Później zdefiniujemy problem i spróbujemy złapać jedno z rozwiązań. Oczywiście jest wiele rozwiązań na rynku, o czym będę uczciwie Wam mówił, natomiast powiem też, które moim zdaniem jest najlepsze i mam nadzieję, że między innymi dlatego się dzisiaj widzimy, żebyście chcieli usłyszeć ode mnie, co mi najlepiej działa. Chcę się z wami tym podzielić.
Później przeprowadzę was przez to, w jaki sposób można to zrobić – jak można się wesprzeć nami bądź jak samemu zacząć tę podróż w danych. Będzie też oczywiście przestrzeń do tego, żebyście mi zadawali pytania, na co bardzo liczę. Jeśli zadacie w czacie pytanie ze znakiem zapytania, to ono mi się przebije do panelu, gdzie będę mógł przez nie przejść. Pamiętajcie o interpunkcji, to ważna sprawa. Już się pojawiło (panel pytań), możecie zadawać je w trakcie, ja raczej odpowiem na końcu, ale będę mógł do nich wrócić.
Agenda webinaru
Dlaczego Twoje dane Cię ograniczają?
- Ręczne łączenie danych z różnych źródeł
- Silosy danych
- Hurtownie danych a BigQuery
Hurtownia Danych (BigQuery)
- Przedstawienie BigQuery i jego działania
- Przegląd usług Google Cloud, które wspierają budowę hurtowni
- Czy AI potrzebuje hurtowni danych?
Hurtownia danych, a jezioro danych
Jak bezpiecznie zacząć drogę do uporządkowanych danych
- Podejście do wdrażania hurtowni danych
- Dojrzałość analityczna firmy
- Case study
Q&A
Ręczne łączenie danych z różnych źródeł
To co, jak myślicie, dlaczego dane nas ograniczają? To jest okej i to jest normalne, że dane w naszych organizacjach są w wielu miejscach i systemach. Mamy Warehouse Management System (WMS), mamy PIMCore, mamy Magento na przykład. To wszystko trzeba ze sobą pozapinać. Czasami analityka danych z wielu źródeł jest po prostu trudna. Rozproszenie powoduje, że trudno je złapać, trudno je między sobą przecinać, często brakuje wspólnych identyfikatorów i pojawia się wiele przyziemnych problemów.
Jest też lag decyzyjny. To niefajna sprawa – nie raz spotykam się z tym, że w kwietniu raportowany jest dopiero luty. Zanim pozbiera się informacje na czyimś komputerze, zdarzy się jakieś chorobowe, trzeba znaleźć wspólne mianowniki… Wtedy specjaliści tracą czas żeby uporządkować te dane, próbować wyłapać wspólne miejsca a wystarczy zazwyczaj jedna zmiana przy dowolnym ze źródeł i raporty sypią się jak domek z kart. Makra napisane w Excelu (mam nadzieję, że dziś piszecie je już przy użyciu AI) i tak się posypią i trzeba je naprawiać. W środowisku SaaSowym rzeczy zmieniają się szybko, API potrafią się zmienić bez ostrzeżenia. Widziałem wiele takich sytuacji wiele w moim zawodowym życiu, integrując się z e-commerce. No i to jest to co nas zwykle blokuje.
Silosy danych
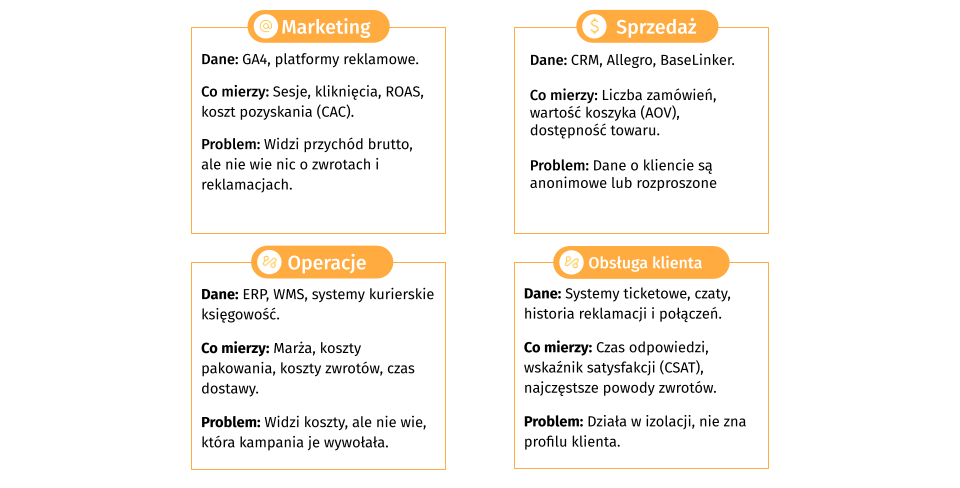
Oprócz tego dane są często w silosach. Marketing zwykle mierzy sesje, ROAS, CAC, ale nie potrafi tego połączyć ze sprzedażą. Sprzedaż widzi swoje rzeczy, a księgowość widzi to, co zaksięgowała – co też nie zgadza się z raportami sprzedaży. To są trudne rzeczy do prowadzenia firmy. Bez tej wiedzy prowadzenie przedsiębiorstwa przypomina wróżenie z fusów lub działanie na „czutkę”, co w długim terminie jest problematyczne. Ta silosowość danych jest też trudna, bo gdy zapytamy księgowość, czym jest sprzedaż, i zapytamy o to samo dział sprzedaży, usłyszymy co innego i to rodzi wiele problemów. Ktoś raportuje sprzedaż jako zaakceptowane zlecenie, mimo że nie ma jeszcze umowy, a faktura za usługę czy towar pojawi się dopiero za kilka miesięcy, na przykład po wykonaniu jakiegoś wdrożenia. To duży problem definicyjny. Dlatego warto w organizacji zwrócić uwagę, żeby posługiwać się wspólnym językiem.
Hurtownię można zbudować na wielu technologiach, a BigQuery jest jedną z nich. Szczerze mówiąc, to moja ulubiona technologia, ponieważ ma bardzo dużo funkcji ułatwiających integrację, wdrożenie i zebranie danych w jedno miejsce. Jest to środowisko łatwe w utrzymaniu, szybkie i całkiem tanie.
Czym jest Google BigQuery
W związku z tym chciałbym Was nieco poznać z BigQuery. To platforma do analityki i przetwarzania danych w czasie rzeczywistym w skali petabajtowej. Jest „self-managed”, czyli nie musimy utrzymywać serwerów ani aktualizować Linuxów. Jest bardzo stabilna i oferuje wysoką klasę bezpieczeństwa, spełniając wszystkie normy, także w Unii Europejskiej. Można wybrać miejsce składowania danych (dataset) w Warszawie, Frankfurcie czy Belgii, a także replikować dane między kontynentami, zapewniając wysoką niezawodność (high availability).
Jak to działa w praktyce? BigQuery można potraktować jak zwykłą bazę danych na „grubych sterydach”. Posiada mnóstwo konektorów ułatwiających pracę. Dane z GA4, Google Ads czy Search Console można pobrać do hurtowni za pomocą czterech kliknięć. To kluczowe, by zacząć przygodę z danymi, zwłaszcza w środowisku Google. Integrować można jednak nie tylko narzędzia Google, ale też Meta Ads, dane z AWS, Azure czy systemy plikowe. Dzięki temu możemy kojarzyć dane między sobą. To już nie jest tak, że Google Analytics ma dane tylko o sobie – możemy je przeciąć przez rzeczywistą sprzedaż, o ile zadbamy o czystość danych na wejściu. Z tego „złota” można wydobywać kolejne warstwy, budować modele danych, widoki analityczne i czytelne dashboardy. Na końcu to wszystko pozwala na wykorzystanie AI.
Przegląd usług Google Cloud, wspierających budowę hurtowni
Tu mamy przegląd usług: BigQuery jako serce, Cloud Storage do plików mniej tabelarycznych, Data Fusion do procesów przesyłania danych, DataPrep do czyszczenia i szukania anomalii.
Jest też Looker (wersja darmowa, Pro oraz Looker platformowy), który pozwala na wizualizację i rozmowę z danymi językiem naturalnym. Cloud Composer to orkiestrator. Z tych klocków układa się odpowiedni zestaw puzzli. Jest też Vertex AI jako platforma do robienia magii z danymi.
Ale jak właściwie BigQuery pozwala „rozmawiać” z danymi? Dzięki Natural Language Query możemy pytać językiem naturalnym i otrzymywać odpowiedź. Mimo wszystko warto znać trochę języka SQL, ponieważ BigQuery może nam wygenerować taki kod i go uruchomić. Trzeba być jednak konkretnym – przy modelach LLM zapytanie bez sprecyzowania (np. czy chodzi o zamówienia opłacone, czy dostarczone) może dać różne wyniki. Rozwiązaniem jest Looker i jego model semantyczny, który opisuje dane i buduje słownik pojęć. Wtedy rozmawiając językiem naturalnym z Lookerem, zawsze otrzymamy identyczną, precyzyjną odpowiedź.
Budowa hurtowni danych bez rewolucji w firmie
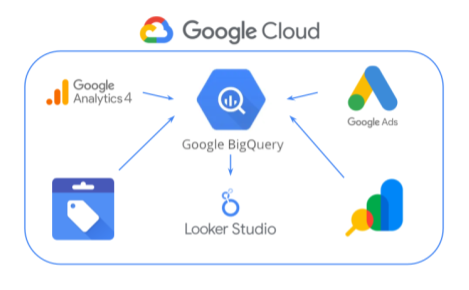
A tu mamy taką małą wizualizację tego jak może wyglądać takie połączenie różnych technologii – oczywiście w dużym uproszczeniu. Jednak tak jak widać, wszystkie te dane z narzędzi jak Google Analytics 4, Google Ads czy Google Merchant mogą być bez dodatkowych usług pobierane do BigQuery, a następnie możemy wszystko analizować w LookerStudio.
Przejdźmy do AI. Słyszeliście pewnie, że „nie ma AI bez danych”. To szerokie hasło. AI wymaga danych do trenowania modeli, ale bez hurtowni danych AI też istnieje, tylko służy do czego innego.
Hurtownia danych bez AI oraz z AI – różnice
Dzielę to na AI generatywny (jak Gemini), który odnajduje się w chaosie, PDF-y, Gmaile i wyciąga z nich informacje. Te dane nie muszą być więc bardzo dobrze ułożone, żeby móc wyciągnąć z nich jakąś wiedzę.
Drugi typ, który lubię nazywać „good old fashioned AI”, czyli uczenie maszynowe (Machine Learning). ML wykorzystujemy tam, gdzie musimy przewidywać, określać skuteczność i trenować własne modele, przetestować je i do tego przeznaczone jest środowisko VertexAI. Dla przykładu, można przygotować model uczenia maszynowego językiem SQL, pozwalający szybko sprototypować rozwiązanie, np. sprawdzić, który klient jest bliski rezygnacji z naszych usług. Więc, jeśli przewidujemy churn klienta na poziomie 80%, możemy wysłać takiemu klientowi kampanię lub kupon i zacząć zarabiać lub przestać tracić na tym, że nie wiemy co się dzieje z naszymi danymi.
Hurtownia danych vs. jezioro danych
Co wybrać: Data Warehouse czy Data Lake? To zależy. Hurtownia danych (Warehouse) to dane uporządkowane, tabelaryczne, służące do szybkiej analizy i wyciągania wniosków. Data Lake (Jezioro danych) to miejsce, gdzie wrzucamy wszystko: wideo, zdjęcia, PDF-y, czujniki IoT. Służy ono głównie do przechowywania. Zwykle najlepiej jednak spisują się rozwiązania hybrydowe – Data Lakehouse. Zaczynamy od jeziora, z którego wybieramy istotne dane do hurtowni.
Podejście we wdrażaniu hurtowni danych i dojrzałość analityczna
Jak bezpiecznie zacząć? My we Fly on the Cloud opieramy się na MVP (Minimum Viable Product). To coś, co sprawdza koncept, a jednocześnie od razu daje wartość. Często jest to rozwiązanie, z którego firma już nie chce zrezygnować. Ważny jest szybki „time to value”. Warto zacząć jak najszybciej – np. GA4 po podpięciu pod BigQuery odda dane historyczne, ale każdy dzień zwłoki to strata danych, których nie da się odzyskać wstecznie w tej formie. MVP jest tańsze, zmniejsza ryzyko i ułatwia adaptację. Pozwala podejmować mądre decyzje, które przekładają się na pieniądze – oszczędności lub dodatkowy zarobek. Te projekty często same się finansują już w fazie MVP.
A żeby zacząć wdrożenia musimy wiedzieć na jakim etapie dojrzałości analitycznej jesteśmy. Jest to swojego rodzaju ścieżka, którą musi przejść organizacja, żeby znaleźć się w tym ostatecznym, optymalnym stadium. Wyróżniamy cztery poziomy:
- Reaktywny: Walka o oddech, dane w Excelach i CSV, duże opóźnienia, podatność na błędy i ogromny koszt czasu ludzi.
- Świadomy: Korzystanie z gotowych paneli (GA4, Ads), ale działy widzą co innego i nie ma holistycznego obrazu firmy.
- Strategiczny: Dane są uporządkowane, mamy wspólne słowniki, widzimy całą ścieżkę – od leada po fakturę.
- Proaktywny: Wykorzystujemy uczenie maszynowe, by wiedzieć, co się wydarzy, personalizować ofertę i monetyzować dane w mądrzejszy sposób. Życzę nam wszystkim, byśmy byli w tym etapie.
Case study epaka.pl
Case study: epaka.pl – bardzo duży broker kurierski, który pozwala nam zamówić kuriera z wielu firm, a także wysyłać paczki w nawet bardzo odległe i egzotyczne zakątki świata Raportowanie tam było spóźnione, oparte na Excelach.
Zrobiliśmy analitykę w czasie rzeczywistym na Google Cloud. Dane z systemów produkcyjnych trafiają bezpośrednio do BigQuery, a zarząd korzysta z Lookera. Widzą na żywo stan firmy: liczbę wysyłanych paczek, telefony konsultantów, opóźnienia i obroty sprzed sekundy. Wykorzystujemy predykcję, by sprawdzać, kto przestaje wysyłać paczki.
Efekt? 153% wzrostu liczby zamówień dzięki decyzjom opartym na danych – zarówno tym marketingowym, jak i strategicznym, ponieważ w ich hurtowni możemy doglądać zarówno linie produktowe, jak i dane z Google Analitics. Co więcej dzięki AI można też odsłuchać nagrania z call center, zrobić transkrypcję i przeanalizować je.
Demo dostępne na nagraniu (czas: 38:00)
Na koniec nagroda dla was – pokażę Lookera platformowego. To jest demo „Data Beans” – pokazuje na żywo food trucki z kawą w Londynie. To prawdziwy raport. Widzimy oś czasu, okazje sprzedażowe (np. koncert), prognozy ruchu przechodniów na podstawie kamer. Możemy wygenerować przez AI nowy napój (np. Hazelnut Haven), sprawdzić składniki i od razu odpalić kampanię na Instagramie czy wysłać maila do klientów. System podpowiada, że w sobotę będzie padać, więc warto przekierować food trucki nad Tamizę, co zwiększy przychód o 5 tysięcy. Looker potrafi też prostsze rzeczy: analizę sprzedaży miesięcznej, trendów, średniego koszyka. Możemy zapytać AI: „Podsumuj to w stylu executive” albo zadać pytanie: „Jakie produkty najlepiej sprzedawały się w zeszłym miesiącu?”. System rozumie intencję i daje precyzyjny wynik, bo dane w BigQuery są wcześniej opisane.
Pamiętajcie, że odpowiedzialność za decyzję zawsze leży po stronie człowieka. My jesteśmy odpowiedzialni za to, co zrobimy z odpowiedzią AI. To wszystko, co przygotowałem. Zachęcam do kontaktu mailowego z naszym zespołem.
Mariusz Wilczek: Nie widzę więcej pytań. Mariusz, dzięki ci bardzo. Bardzo fajnie było usłyszeć o hurtowni danych i zobaczyć te imponujące fajerwerki. Ja jestem w szoku, że mamy aż tak mocny wgląd w to wszystko. Dziękuję uczestnikom za czas. Prześlemy nagranie z webinaru i podsumowanie. Życzę miłej reszty dnia i wesołych świąt.
Mariusz Zyśk: Trzymajcie się, do usłyszenia.