
Obejrzyj nagranie z webinaru:
Bezpieczeństwo IT zaczyna się od planu
Czego się dowiesz?
Obejrzyj nagranie webinaru poświęconego budowaniu skutecznych strategii utrzymania ciągłości działania systemów. Ekspert FOTC, Piotr Gocłowski, wyjaśnia, dlaczego bezpieczeństwo IT wymaga konkretnego planu oraz jak disaster recovery chroni firmę przed ogromnymi finansowymi i wizerunkowymi skutkami awarii. Z nagrania dowiesz się, czym różni się wysoka dostępność (High Availability) od Disaster Recovery (DR), jak prawidłowo zdefiniować kluczowe wskaźniki RTO i RPO oraz jak bezpiecznie przesyłać i odzyskiwać dane w środowisku chmurowym Google Cloud Platform.
TRANSKRYPCJA WEBINARU
Webinar: Bezpieczeństwo IT zaczyna się od planu
Data: 29.04.2025
Prelegent: Piotr Gocłowski
Wstęp i powitanie uczestników
Magdalena Cuper: Witam wszystkich serdecznie na naszym webinarze: „Bezpieczeństwo IT zaczyna się od planu”. Bardzo się cieszę, że dołączyliście i poświęciliście swój czas, szczególnie, że teraz tydzień majówkowy, więc bardzo się cieszę, że możemy się dzisiaj zobaczyć i że Piotr będzie mógł dla was przedstawić tak ciekawą prezentację, jaką przygotowaliśmy.
Dla tych z was, którzy są z nami po raz pierwszy, FOTC to wiodący dostawca rozwiązań chmurowych. Specjalizujemy się w doradztwie technologicznym, usługach IT, danych i sztucznej inteligencji oraz w usługach zarządzanych. Naszym celem jest dostarczanie kompleksowych rozwiązań, które zapewniają bezproblemową implementację, integrację i wsparcie technologiczne. I chciałabym już też teraz serdecznie zaprosić państwa do kontaktu z nami, z zespołem FOTC. Jako partner Google Cloud oferujemy szeroki wybór pakietów wsparcia i doradztwa dopasowanych do różnych potrzeb. W razie pytań jesteśmy tutaj, aby pomóc.
Dzisiejszy webinar obejmuje:
- Dlaczego disaster recovery jest kluczowy,
- jak stworzyć skuteczny plan,
- przygotowanie na awarię,
- jak skutecznie odzyskać dane,
- disaster recovery dla baz danych.
Naszym ekspertem jest dzisiaj Piotr Gocłowski jako inżynier chmury specjalizujący się w Google Cloud Platform oraz lider zespołu technologicznego z pasją zagłębia najnowsze osiągnięcia w dziedzinie informatyki, technologii i nauki. Jego wiedza ekspercka opiera się na wykształceniu w zakresie inżynierii mechatronicznej oraz praktycznym doświadczeniu z przemysłowymi systemami komunikacji.
Zachęcam też do zadawania pytań. Webinar będzie nagrany i wysłany w ciągu czterech dni roboczych. I już teraz przekazuję głos do Piotra i życzę państwu miło z nami spędzonego czasu. Dziękuję ślicznie.
Piotr Gocłowski: Dzień dobry. Witam wszystkich bardzo serdecznie. Sekundkę udostępnię tylko prezentację. Chciałem zapytać, czy mnie słychać i czy widać prezentację. Okej, dobrze. Wobec tego będziemy zaczynać. Tak, dzisiaj opowiem o disaster recovery, a konkretnie o metodach, sposobach i praktykach.
Dlaczego Disaster Recovery jest ważne
Zacznijmy więc od tego, dlaczego recovery jest ważne. Typowe zdarzenia, które mogą zakłócić działanie usług IT, działanie aplikacji, to klęski żywiołowe i zdarzenia spowodowane przez człowieka. Możemy przeciwdziałać tym żywiołowym poprzez wdrażanie środowisk w niezależnych geograficznie lokalizacjach na przykład. A na błędy ludzkie możemy wdrażać wewnątrz organizacji różne sposoby.
Warto powiedzieć, że każdy przestój aplikacji bądź usługi oznacza straty. Oznacza straty dla przedsiębiorstwa i istnieją raporty, które dosyć dobrze obrazują dlaczego warto mieć disaster recovery. Według badań uśredniony koszt takiej kilkuminutowej przerwy dużego systemu przedsiębiorstwa waha się od kilku tysięcy, nawet do 9 000 dolarów dla dużego przedsiębiorstwa. Dla mniejszych firm, małych i średnich, będzie to kilkaset dolarów. Dla takich gigantów jak Amazon wyniesie to nawet kilka milionów. Tak, dlatego zdecydowanie warto. Oprócz strat typowo finansowych nasza firma może też wizerunkowo nieco stracić, co jest ciężko mierzalne, ale istnieje.
Disaster Recovery a High Availability
Disaster recovery plan może się wydawać czymś podobnym, a właściwie Disaster Recovery, czymś podobnym do high availability. W skrócie DR jest widokiem szerszej perspektywy dla większej części systemu. Pozwala uniknąć awarii bardziej globalnych, szerszych. A HA (high availability) to tak naprawdę jest charakterystyka systemu, która opisuje jego dostępność, tak? Czyli jeśli mamy bazę danych, która ma swoje HA, no to na przykład zwykle jest tak, że ma wdrożoną dodatkowo w najprostszym scenariuszu read replikę, która gdzieś tam sobie pracuje jako backup.
Także HA całkowicie się nie pokrywa z DR (disaster recovery), ale często konieczne jest uwzględnienie HA, gdy rozważa się metryki, o których powiem za chwilę więcej: RTO (recovery time objective) i RPO (recovery point objective).
Kluczowe metryki: RTO i RPO
A czym one właściwie są?
Recovery point objective (RPO) to jest czas w trakcie wystąpienia awarii, który upłynął od wykonania ostatniej kopii zapasowej danych bądź baz danych, bądź jakichś danych obiektowych. Czyli wynika to z częstotliwości wykonywania kopii zapasowych i definiuje nam tak naprawdę, jak powiedzmy stare w cudzysłowiu te dane mamy.
A RTO to jest Recovery Time Objective i to nam definiuje, jak szybko od wystąpienia awarii jesteśmy w stanie uruchomić nasze środowisko zapasowe. Także te dwa parametry są dosyć kluczowe i warto je zdefiniować dla naszych aplikacji, dla naszych usług, per aplikacja, per usługa, ponieważ jeśli mamy tego więcej, to możemy też na podstawie krytyczności wybrać, że chcemy na przykład tylko dla części aplikacji, części usług tworzyć DR.
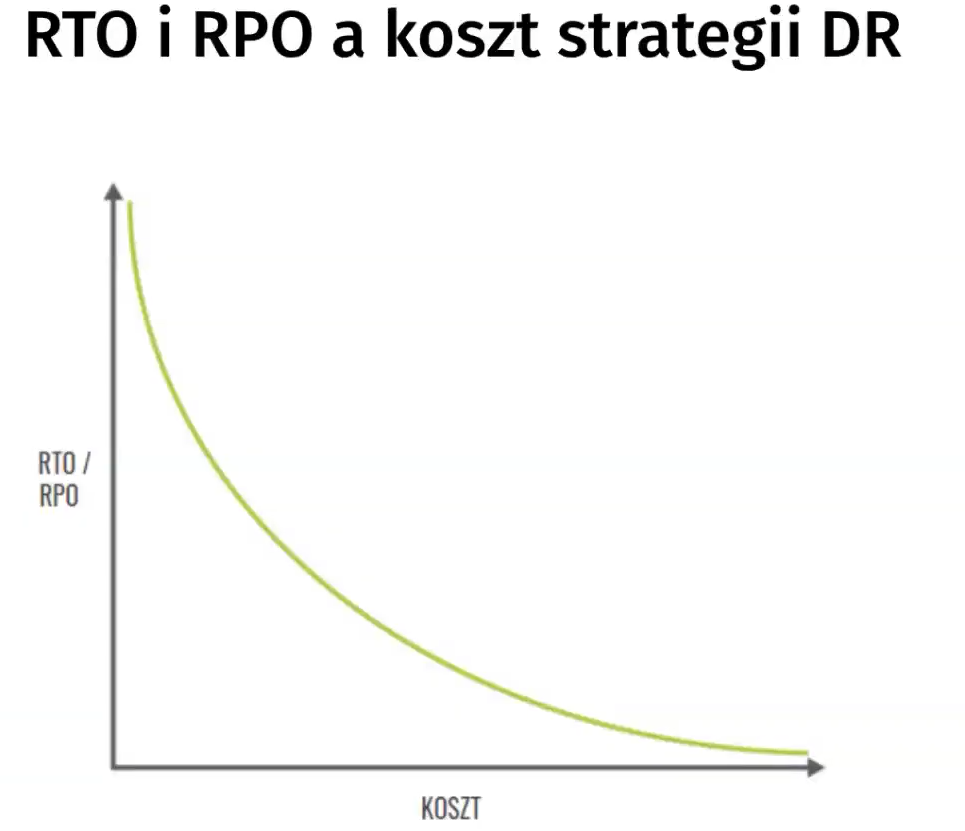
Ważnym aspektem dla każdego przedsiębiorstwa są koszty. Dlatego warto wiedzieć, że z RTO i RPO możemy tak naprawdę wyżyłować się na maksa, ale wiąże się to z większymi kosztami, prawda? Niskie wartości RTO i RPO będziemy mieli dla kopii zapasowych, takich typowych kopii zapasowych robionych cyklicznie z naszego środowiska lokalnego do chmury i to będzie najbardziej optymalne kosztowo, ale jednocześnie czas uruchomienia, czas odzyskania aplikacji, usługi z takich kopii jest najdłuższy. Dlatego im więcej zasobów postawionych gdzieś w środowisku zapasowym odzwierciedlającym nasze środowisko podstawowe, tym koszt jest większy, to prawda, ale jednocześnie czas uruchomienia od wystąpienia awarii jest lepszy, jest krótszy, także to trzeba dobrze zbalansować.
Wzorce DR na przykładzie opon samochodowych
Tak. I teraz dobrą analogią dla tych wzorców, zresztą Google też jej używa, są opony samochodowe. Na pierwszy rzut oka nie mają zbyt wiele związku z infrastrukturą IT. Jednak jeśli się zastanowimy nad koncepcją koła zapasowego i sposobów jak sobie z tym radzić, to już tutaj jest bardzo dużo analogii.
Przy takim zimnym wzorcu to jest sytuacja, w której nie mamy koła zapasowego i musimy zadzwonić po pomoc drogową. Nasza podróż jest zatrzymana, podobnie jak świadczenie usługi bądź aplikacji. No i wtedy mamy przestój i jest on dłuższy, jest jakaś przerwa w usłudze.
Przy warm standby bądź po prostu warm sytuacja wygląda trochę lepiej, ponieważ mamy koło zapasowe. Jesteśmy w stanie wymienić je dosyć sprawnie, jednak jakiś przestój będzie, ale nie tak długi jak w tym pierwszym scenariuszu.
I trzeci scenariusz, nasze hot standby, to jest sytuacja, gdy mamy opony w samochodzie założone tak zwane runflaty. Runflat, czyli opony, w których gdy przebijemy oponę, nadal możemy ze zmniejszoną prędkością podróżować. No i to jest scenariusz taki najfajniejszy, ale jednocześnie najdroższy, bo takie opony też kosztują znacznie więcej niż klasyczny zestaw. Więc tak wygląda analogia.
Przygotowanie planu Disaster Recovery
Dobrze. Wiemy więc już jakie są wzorce Disaster Recovery. W tej sekcji opowiem kilka słów o tym, jak przygotować taki plan, jakie są najważniejsze koncepcje. Tak jak wspominałem, te wartości RTO i RPO są dosyć istotne, bo to one nam definiują ten wzorzec odzyskiwania, ten wzorzec DR. Na ich podstawie, na podstawie krytyczności aplikacji musimy wyznaczyć odpowiedni sposób, w jaki będziemy te dane backupować albo w jaki sposób będziemy się łączyć do chmury i tak dalej, o czym opowiem później.
End-to-end design, czyli ważne, aby zaplanować całość takiego planu. Musimy myśleć o tym, jak tworzymy te kopie zapasowe, jak je transferujemy, przesyłamy, jak je odzyskujemy, a także o tym, w jaki sposób wygląda rollback, tak? Czyli w momencie, gdy nasze podstawowe środowisko już wstało po awarii, już działa, już może świadczyć usługę, no to musimy też pamiętać, w jaki sposób z tymi danymi wrócić, z tymi danymi ze środowiska Disaster Recovery, ponieważ nasi użytkownicy niemal na pewno wygenerowali jakieś dane w bazach danych bądź dane obiektowe.
Konkretność takiego planu – musi on być przejrzysty, szczegółowo opisywać poszczególne zadania, co i jak będzie się działo, tak żeby osoba postronna, osoba z zespołu mogła też taki plan wykorzystać.
Kolejnym ważnym aspektem jest obserwowalność. Chodzi o to, że warto pomiarować swoją aplikację, zarówno on-premisową – to jest taka praktyka szeroko stosowana, ale zdarzają się wyjątki. Warto po prostu śledzić, tak zwane health checki porobić dla aplikacji, dla usługi, tak żeby móc wykrywać zdrowie, stan usługi, a także sytuacje, gdy mamy po prostu awarię.
Weryfikacja. Przy Disaster Recovery musimy ciągle pamiętać o weryfikacji planu. Musimy weryfikować, czy nasza infrastruktura jest prawidłowo wdrożona, czy nasze pipeline’y CI/CD są w stanie współpracować z tym środowiskiem Disaster Recovery. A także, tak jak wspominałem wcześniej, musimy z tyłu głowy mieć ten rollback dla powrotu do środowiska podstawowego, czyli robić też testy i weryfikacje tego aspektu.
Oczywiście compliance. Szczególnie dla organizacji, które są silnie uregulowane, muszą przestrzegać dodatkowych zasad, to ten compliance też będzie miał znaczenie.
Kolejne aspekty, które musimy wziąć pod uwagę, to bezpieczeństwo – bezpieczeństwo, zgodność i gotowość takiego środowiska. Musimy też dla naszego zespołu, który będzie się opiekował takim DR, odzwierciedlić dostęp, tak żeby osoby, które mają domyślny dostęp do środowiska podstawowego, miały też taki sam dostęp zmapowany dla środowisk chmurowych.
Tak, musimy też zapewnić szkolenia dla tych administratorów z użyciem tego planu. No i musimy też testować dane produkcyjne – musimy traktować dane produkcyjne i odzyskane na równi. To, co wspominałem wcześniej, że przy rollbacku, czyli przy powrocie ze środowiska zapasowego, te dane są tak samo ważne i trzeba je odpowiednio scalić w środowisku podstawowym.
Transfer danych i łączność ze środowiskiem chmurowym
Kolejny element istotny dla DR to jest transfer danych i łączność z Google Cloudem bądź innym środowiskiem. Gdy tworzymy taki plan, trzeba zastanowić się, w jaki sposób chcemy te dane przesyłać do infrastruktury zapasowej – czyli czy mamy jakieś regulacje odgórne, żeby używać szyfrowanego połączenia, czy na przykład wymiana danych jest niemożliwa po API, a tylko jedynie w warstwie sieciowej trzeciej. I tutaj właśnie na podstawie tych pytań będziemy w stanie dobrać odpowiednio connectivity pomiędzy środowiskami i po prostu zaplanować ten nasz plan.
Inne kluczowe praktyki przy takim disaster recovery to warto zastanowić się nad redundancją ścieżki odzyskiwania danych, tak żeby nasze środowisko podstawowe w tym momencie miało jakąś inną ścieżkę.
Warto też automatyzować tę infrastrukturę, która będzie uruchamiana w chmurze. Można do tego użyć Terraform bądź Deployment Managera domyślnie w Google. Monitoring środowiska, to już wspominałem, to jest zawsze coś, co warto robić, coś, co warto stosować. No i testowanie planu regularnie, zarówno pod kątem bezpieczeństwa, jak i pentestów oraz w przypadku scenariusza braku dostępu do chmury.
Tworzenie kopii zapasowych w Google Cloud
I generalnie pewnie większość z nas, na pewno większość administratorów, wykonuje kopie zapasowe. To jest bardzo dobra praktyka i jeśli ktoś tego nie robi, to zdecydowanie polecam. I pierwszym takim krokiem, najbardziej podstawową rzeczą jaką możemy robić, to jest właśnie tworzenie kopii zapasowych. W przypadku Google Clouda możemy to robić na kilka sposobów. Ja opiszę dwa z nich.
Najprostszy możliwy scenariusz to jest użycie konsoli webowej i po prostu przerzucanie tych danych ręcznie. Jednak jak wiadomo, ręczne wykonywanie czegoś jest w IT generalnie niemile widziane, bo jest podatne na błędy, jest podatne na przeoczenia. Dlatego można użyć googlowego narzędzia CLI Gcloud. Można je zainstalować zarówno w systemach Linux, jak i Windows. I w ten sposób możemy krótką komendą kopiować dane regularnie z jakimś harmonogramem zadań w Windowsie albo za pomocą Crona na systemach Linuxowych. Możemy kopiować te dane regularnie do usługi Cloud Storage. Ta usługa jest dosyć tania i naprawdę warto ją chociaż poznać, bo nie ma tam żadnego utrzymania jak na przykład typowy NAS, czyli network-attached storage, który jest stosowany też do backupów.
Inną drogą do robienia takich kopii zapasowych z użyciem Google i Cloud Storage jest gotowa usługa Storage Transfer Service. Możemy w niej za pomocą pobieranego agenta też cyklicznie wykonywać te kopie. Jest to nieco bardziej zautomatyzowane i nie musimy tworzyć takiego zadania w menedżerze zadań albo w Cronie.
I tutaj chciałem też powiedzieć dosłownie dwa słowa na temat storage’u. Jeśli mamy kopie zapasowe, które nie są takie powiedzmy gorące, które mogą zostać odłożone na długi czas, ale musimy to robić, jesteśmy do tego zobowiązani, to warto zastanowić się nad tym, jak używać Cloud Storage. Tam istnieją cztery klasy przechowywania. Taka najbardziej podstawowa to jest Standard i ona jest jednocześnie najdroższa – to znaczy to jest tania usługa, ale kosztuje relatywnie najdrożej – i wraz z tymi kolejnymi klasami, czyli Nearline, Coldline, Archive, te koszty przechowywania maleją. Także przy większych ilościach danych zdecydowanie to ma znaczenie dla kosztów, dla FinOpsa.
Scenariusze architektoniczne: Cold, Warm i Hot
I teraz przejdziemy do scenariuszy. Opowiem o kilku scenariuszach dla całej aplikacji, łącznie z bazą danych.
Przejdźmy więc na początek – mamy wzorzec Cold. W tym wzorcu na środowisku lokalnym mamy pracujący web serwer z aplikacją. Jest jakiś backend, jest serwer bazodanowy. Pomiędzy środowiskiem lokalnym a chmurą mamy zestawione połączenie. Połączenie to może być albo VPN, albo Dedicated Interconnect w zależności od potrzeb.
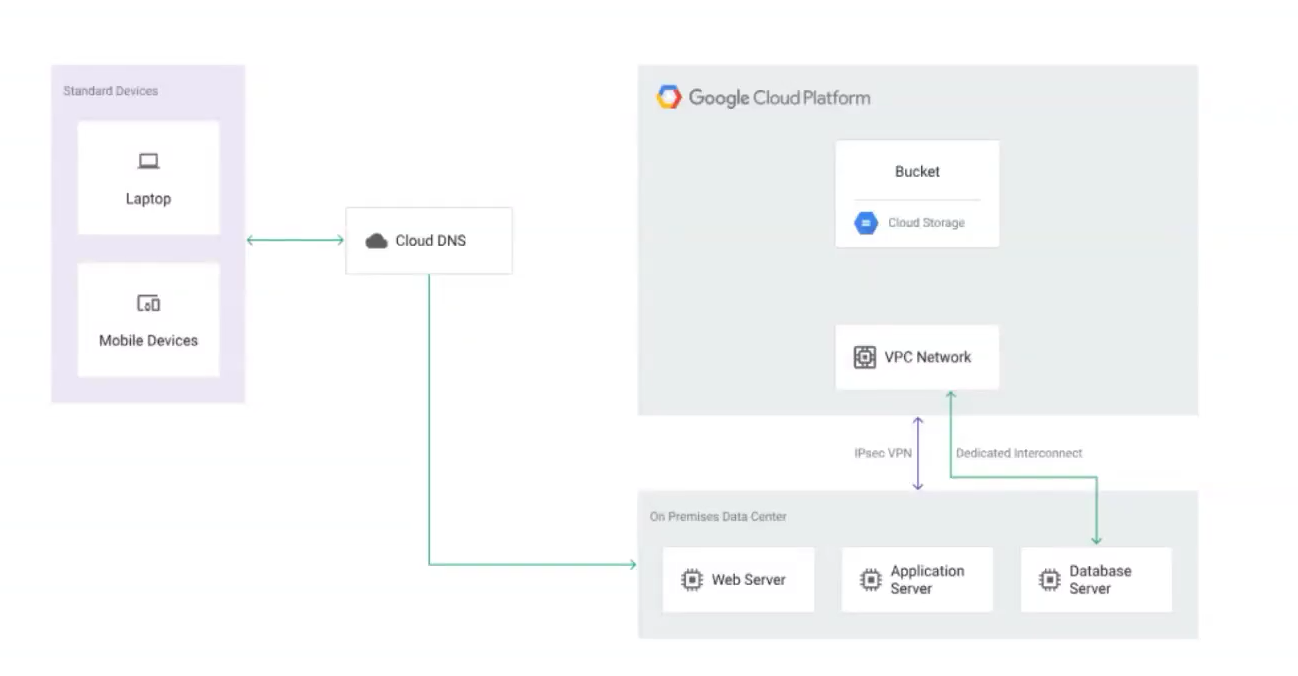
I generalnie w tym scenariuszu to jest trochę taki scenariusz jak z brakiem koła zapasowego. Czyli tak naprawdę w sytuacji, gdy nasze środowisko podstawowe przestanie działać, musimy się ręcznie przełączyć. Musimy przełączyć DNS-y na nowe środowisko. Jeszcze tutaj dopowiem, że tunel Dedicated Interconnect w tym przypadku nawet nie do końca musi być konieczny, bo w Google Cloud większość rzeczy robimy przez API. Jeśli na przykład nie mamy jakiejś typowej replikacji bazy przez protokoły UDP/TCP, no to większość rzeczy, kopie zapasowe, możemy wykonywać przez API, więc nawet tych połączeń nie musi być ustanowionych.
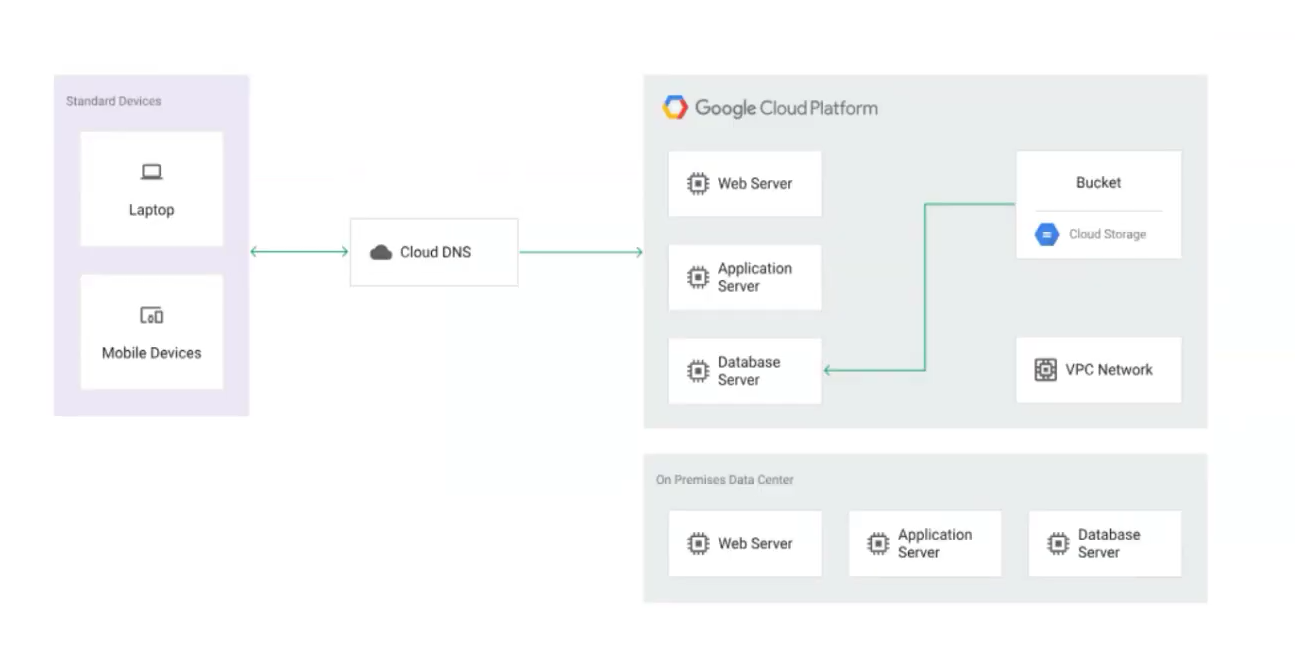
Tutaj mamy właśnie sytuację awaryjną, czyli nasze środowisko podstawowe lokalne przestało działać i musimy ręcznie przełączyć się na środowisko chmurowe. Oczywiście ręcznie mam na myśli w tym wzorcu Cold, czyli przełączam DNS-y. Wcześniej musimy postawić aplikację na maszynie wirtualnej bądź jakoś inaczej. Najlepiej jest to zrobić za pośrednictwem Load Balancera. No i postawienie takiej infrastruktury chwilę trwa. Dlatego mamy tę przerwę i po prostu tak jest. Warto zdecydowanie używać do tego typu scenariuszy zautomatyzowanych skryptów, które tworzą nam środowisko, tworzą nam infrastrukturę, na przykład z Terraform albo Deployment Managera.
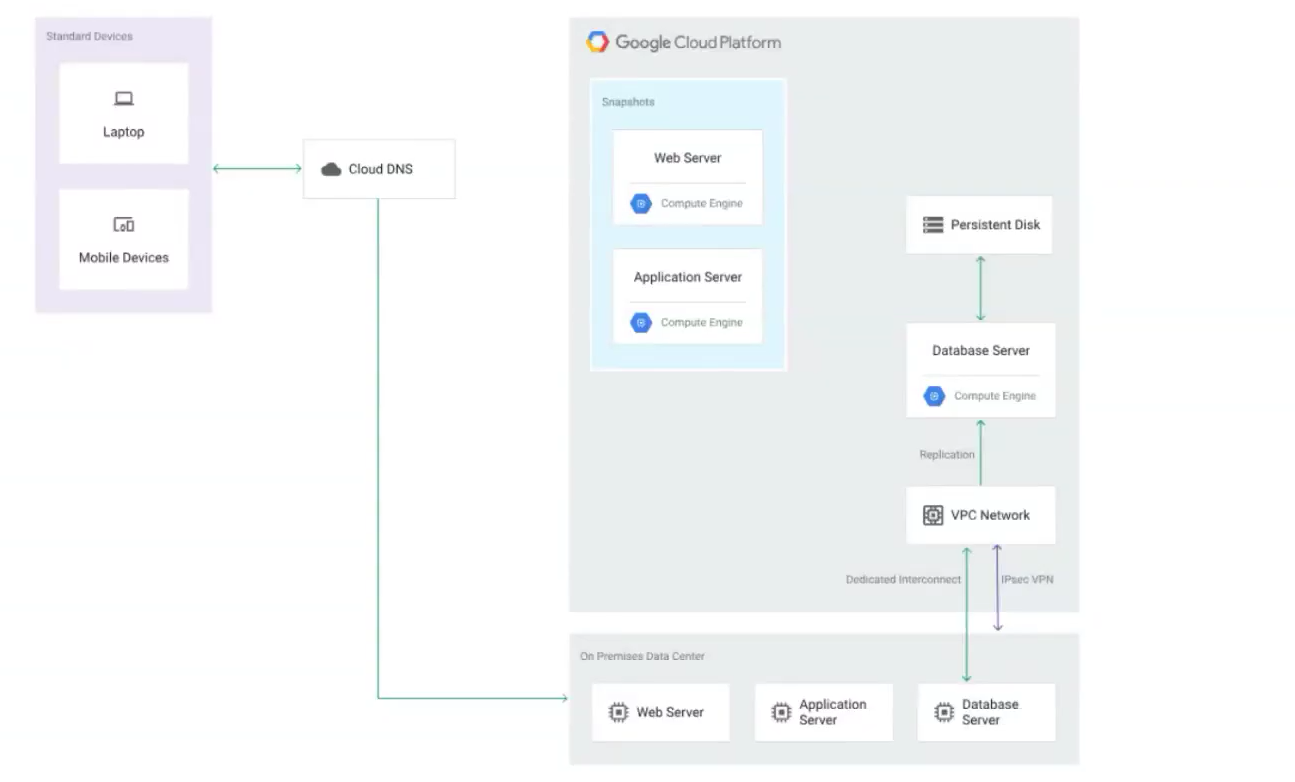
Kolejny scenariusz to jest model Warm, czyli mamy koło zapasowe. I tutaj jakie są zalety tego? Przede wszystkim są lepsze czasy odzyskiwania, ponieważ czasy RPO i RTO są krótsze. Tylko że oczywiście kosztem kosztów. Czyli widzimy – mamy w tym scenariuszu bazę danych, która się replikuje do środowiska chmurowego, czyli cały czas mamy tę bazę odzwierciedloną. Baza danych lokalna jest odzwierciedlona na środowisko chmurowe. Tutaj akurat w tym przypadku już jakieś połączenie tunelowe będzie potrzebne właśnie do tego, żeby ta baza danych tutaj była. I może to być na przykład zarządzany tunel VPN Google’a albo jakiś własny tunel, jakaś własna technologia VPN-owska albo open source’owa. Tak, to jest generalnie dobry kompromis cena do jakości, bo mamy przyzwoite czasy przy powiedzmy umiarkowanym koszcie.
I co się dzieje w sytuacji awarii? W sytuacji awarii uruchamiane są dodatkowe serwery webowe i backendowe. Przełączony jest ruch DNS na te serwery i jednocześnie możemy to zautomatyzować. Dostawca DNS-ów posiada API bądź posiada jakiś inny mechanizm – najczęściej będzie to API – to możemy utworzyć skrypt, który będzie nam monitorował w chmurze Google’a, czy nasze środowisko podstawowe działa, czy świadczy usługę. W sytuacji wystąpienia awarii, w sytuacji niedostępności przełączy DNS-y tak, żeby kierowały na te serwery już pracujące właśnie w środowisku DR. Oczywiście po wdrożeniu, po uruchomieniu tych dodatkowych serwerów w chmurze. Tak to wygląda. Na koniec trzeba pamiętać, żeby zrobić rollback danych, czyli żeby te dane z bazy danych zostały z powrotem, ta różnica została przetransferowana z powrotem do środowiska podstawowego i żeby te dane odpowiednio scalić.
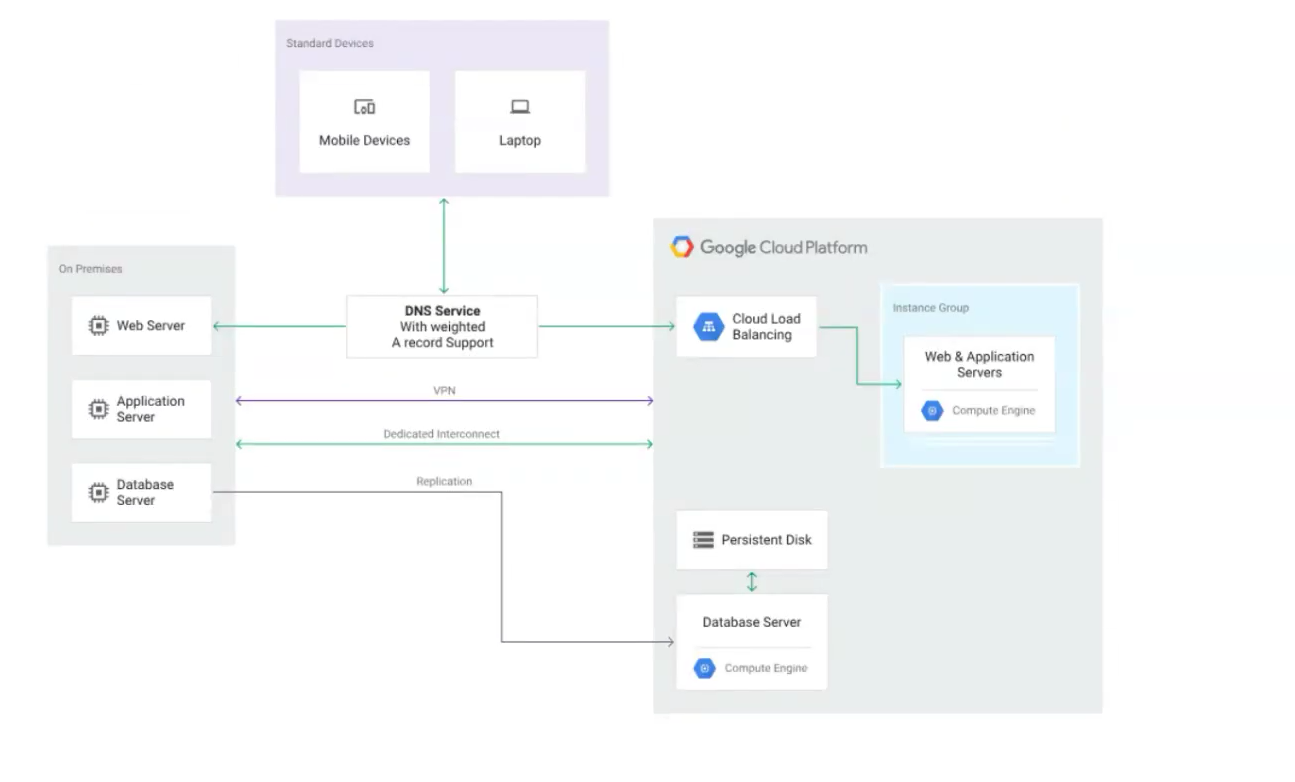
Ostatni wzorzec, który jest tutaj takim świętym graalem, to jest wzorzec Hot. I to jest takie podejście trochę hybrydowe. Można to porównać do load balancingu, tego równoważenia obciążenia pomiędzy kilkoma środowiskami. Tutaj mamy ważony DNS, czyli DNS, który umożliwia za pomocą wag odpowiednie zdefiniowanie kierowania ruchu pomiędzy dwoma środowiskami. Czyli jednocześnie taka aplikacja, usługa może być świadczona z obu środowisk. Ma to dużą zaletę, ponieważ w sytuacji, gdy środowisko lokalne, on-premisowe bądź inna chmura przestanie działać, przestanie odpowiadać na zapytania, to wtedy nasza infrastruktura zapasowa nadal jest dostępna i tak naprawdę bez żadnej zmiany konfiguracji działa cały czas. To jest najfajniejszy scenariusz pod kątem czasów, bo tutaj praktycznie nie ma przerwy. Dla użytkownika końcowego mamy ciągłość działania, jest zachowany komfort i nie mamy strat wynikających z przestoju.
Oczywiście z wad – trzeba wspomnieć, że tutaj płacimy najwięcej, no bo musimy cały czas mieć postawioną odpowiednią infrastrukturę, maszyny wirtualne bądź klaster Kubernetes, bądź jakieś usługi managed typu Cloud Run, które hostują nam te aplikacje. I cały czas jakieś tam lekkie koszty będzie to generować, ale zalet jest też sporo.
Podsumowanie zasad disaster recovery
Jeśli chodzi o scenariusze, to już wszystko. Chciałem tylko teraz trochę podsumować, jakie są najważniejsze, kluczowe zasady przy tworzeniu DR.
Oczywiście musimy pamiętać, żeby wybrać ten wzorzec, czyli w jakim wzorcu nasza aplikacja będzie pracować. Potem określamy te wzorce na podstawie tego wyboru. Z tego będą wynikać czasy RTO i RPO. Musimy sprawdzić, czy to nas satysfakcjonuje. Jeśli nie, to wybrać inny wzorzec.
Musimy też pamiętać, żeby określić zależności systemu i aplikacji. Czyli jeśli mamy jakiś serwer bądź bazę danych, bądź po prostu jakąś aplikację, to żeby znać wszystkie jej zależności, tak żeby w przypadku awarii być w stanie przenieść i odtworzyć wszystkie niezbędne zależności w środowisku zapasowym.
Dostęp i bezpieczeństwo – tak jak wspomniałem, musimy pamiętać o odpowiednim zmapowaniu naszego środowiska, naszych polityk bezpieczeństwa i dostępu, tak żeby te same osoby z zespołu administracyjnego, zespołu DevOps miały te dostępy tak samo odzwierciedlone w środowisku DR.
Zdefiniować musimy też sposób wdrażania tego środowiska, czyli czy wykonujemy to ręcznie, czy za pomocą własnego skryptu bashowego bądź pythonowego, czy robimy to z użyciem Terraform bądź Deployment Managera. Tych możliwości jest kilka.
No i na koniec oczywiście testy i weryfikacja, zarówno planu, jak i środowiska. Tak samo jak przy dewelopmencie oprogramowania, tutaj testy są niezbędnym elementem, bo możemy mieć terabajty kopii zapasowych, możemy mieć wiele replik, ale jeśli w trakcie awarii nie będziemy w stanie przełączyć się bądź odzyskać danych z kopii, no to w zasadzie jest tak, jakby ich nie było.
Współpraca z FOTC i podsumowanie webinaru
Na koniec chciałem wspomnieć kilka słów na temat tego, dlaczego warto współpracować z FOTC w kontekście disaster recovery, ale nie tylko. To, w czym możemy pomóc, to możemy dopasować środowisko disaster recovery do potrzeb. Na podstawie assessmentu, oceny, wywiadu jesteśmy w stanie odpowiednio dobrać środowisko, odpowiednio dobrać zasoby, tak żeby to było kosztowo optymalne.
Wspieramy przy wszelkich zadaniach związanych z obsługą platformy. Możemy dobrać odpowiednie komponenty. Przygotowujemy też plany DR – możemy pomóc w przygotowaniu takiego planu, a także pomóc w jego wdrożeniu z użyciem Infrastructure as Code i możemy też potem być agentem odpowiedzialnym za to środowisko.
Także to wszystko, co dzisiaj przygotowałem. Dziękuję za uwagę i mamy sesję Q&A.
Magdalena Cuper: Bardzo dziękujemy serdecznie. Widzę, że skończymy troszeczkę wcześniej, ale to pewno, drodzy państwo, ponieważ wreszcie w Polsce zawitała ładna pogoda, od razu człowiek ma więcej energii i te prezentacje idą nam po prostu lepiej niż w okresie zimowym.
Gdyby mieli państwo pytania, to chętnie je usłyszymy. Piotr też będzie mógł na nie odpowiedzieć, jeżeli pytania pojawią się po prezentacji, bo tak jak wspomniałam, będziemy wysyłali to nagranie w ciągu czterech dni roboczych i będą mogli państwo na spokojnie się jeszcze raz zapoznać. W tym kontakcie też będziemy od razu informować o adresie mailowym, na którym będzie można przesyłać do nas zapytania.
Więc tak jak już Piotr wspomniał, zachęcamy serdecznie do kontaktu z FOTC. Z mojej strony mogę powiedzieć, że specjaliści, którzy są w firmie, na pewno udzielą państwu wszystkich potrzebnych informacji i odpowiedzą oraz rozjaśnią wszystkie pytania, jakie się pojawiają. Więc jeżeli są teraz pytania, to serdecznie zachęcamy do zadawania ich na czacie. Na razie widzę, że jeszcze pytań nie ma, więc może tutaj faktycznie jeszcze ten moment potrzebny jest do zapoznania się spokojnie z prezentacją.
Piotr Gocłowski: Może ja zadam pytanie, bo jestem w sumie ciekawy. Czy ktoś z państwa już stosował jakieś metody, jakieś scenariusze, które zwiększają niezawodność systemu w disaster recovery? Czy tutaj coś było robione w tym kierunku?
Jeszcze nie. Okej,
Magdalena Cuper: czyli w takim razie to jest idealny moment.
Piotr Gocłowski: Tak, my zachęcamy do współpracy, oczywiście jesteśmy w stanie tutaj niemal na każdym etapie tworzenia takiego planu Disaster Recovery wspomóc.
Magdalena Cuper: Zdecydowanie tak. Nie będziemy państwu już zajmowali więcej czasu. Tak jak wspominałam, to wszystko zostanie jeszcze do państwa przesłane razem z kontaktem. Serdecznie dziękujemy za dzisiejszy udział podczas webinaru i życzymy też przy okazji bardzo udanej majówki.
Dodatkowo chciałabym zaprosić już państwa teraz na webinar, który odbędzie się 21 maja w tematyce Looker Studio i BigQuery. W najbliższych dniach pojawi się informacja na naszych social mediach, do których obserwowania zachęcam, gdzie będą mogli państwo się zapisać. Tam będziemy mieli gościa, więc zachęcamy do zapisów.
Jeszcze raz ślicznie dziękujemy i życzymy spokojnego dalszego dnia.
Piotr Gocłowski: Dziękuję bardzo za uwagę i słonecznej majówki. Bardzo dziękujemy. Do widzenia.